
Tian Yuandong: Bilancio di fine anno 2025 (Parte 1)

Rapporto Xinzhiyuan
Rapporto Xinzhiyuan
【Introduzione Xinzhiyuan】Dal tentativo di salvare Llama 4, finendo invece licenziato, fino ad intraprendere ora un percorso imprenditoriale, il grande esperto di AI Tian Yuandong ripercorre alcuni momenti importanti del 2025.
Recentemente sono stato troppo impegnato, quindi ho potuto scrivere il riassunto di fine anno solo dopo il 1° gennaio; in ogni caso, l'importante è iniziare a scrivere.
Alla fine di gennaio 2025, quando mi è stato chiesto di unirmi al team di emergenza perLlama4, essendo sempre stato impegnato nel reinforcement learning, avevo preparato in anticipo una matrice di ricompensa 2x2 per calcolare le quattro possibili situazioni (anche se, all'epoca, a causa dell'enorme pressione dall'alto, dissentire era quasi impossibile):
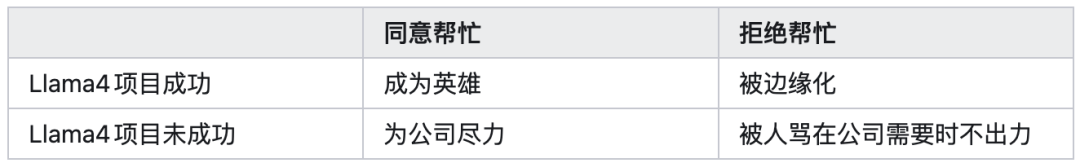
All'epoca pensavo che, andando ad aiutare, anche se il progetto non fosse andato a buon fine, almeno avremmo fatto del nostro meglio e non avremmo avuto rimorsi. Purtroppo, però, alla fine è successo un quinto scenario, non previsto nei calcoli, che mi ha dato una comprensione più profonda della complessità della società.
Nonostante ciò, durante i mesi di intenso lavoro abbiamo comunque esplorato alcune questioni fondamentali dell'addestramento reinforcement learning, come la stabilità dell'addestramento, l'interazione tra training e inference, la progettazione dell'architettura del modello, l'interazione tra pre-training e training intermedio, gli algoritmi per catene di ragionamento lunghe, i metodi di generazione dati, la progettazione di framework di post-training, ecc.
Questa esperienza è stata davvero importante e ha portato un grande cambiamento nel mio modo di fare ricerca.
Inoltre, avevo già pensato che, dopo più di dieci anni in azienda, prima o poi avrei dovuto andarmene; non si può certo restare per tutta la vita, ma per vari motivi economici e familiari ho continuato a restare.
Negli ultimi due anni, sia nel parlare che nell'agire, ho sempre avuto la mentalità di "che l'azienda mi licenzi pure", e questo mi ha reso sempre più libero.
Alla fine del 2023, quando ho preso la mia prima lunga vacanza, ero quasi sul punto di andarmene, ma alla fine non ho firmato e ho deciso di restare, quindi prendere davvero la decisione di lasciare non è facile. OraMetami ha aiutato a farlo, e va bene così.
Questa vicenda, insieme agli alti e bassi di quest'anno, mi ha fornito molto materiale nuovo per i prossimi romanzi che scriverò.
Come si dice, "La sfortuna nella carriera è fortuna per il poeta; scrivere versi sulla maturità della vita porta maestria". Se la vita è troppo monotona, forse non c'è divertimento. Ricordo che all'inizio del 2021, poiché nel resoconto di fine anno avevo scritto qualche riflessione sul motivo per cui nessun paper era stato accettato, sono stato "promosso" Meet Most, con una sensazione improvvisa di non essere all'altezza.
Ma pensandoci bene, invece di lamentarmi della sorte, tanto vale fingere davanti a tutti di essere appena stato promosso; e infatti, dopo sei mesi, la promozione è arrivata davvero, e quel lavoro ignorato all'inizio del '21lavoro, a luglio 2021 ha ricevuto l'ICML Best paper honorable mention, diventando un articolo abbastanza noto nell'ambito della rappresentazione di apprendimento.
Per un certo periodo dopo il 22 ottobre, praticamente tutti i miei canali di comunicazione sono stati sommersi: ogni giorno innumerevoli messaggi, email, inviti a riunioni remote o incontri di persona, non riuscivo a gestire tutto.
Solo dopo alcune settimane la situazione è tornata gradualmente alla normalità. In questi due mesi ringrazio tutti per l'attenzione e la passione. Se in quel periodo non ho risposto tempestivamente a qualche messaggio, chiedo scusa.
Alla fine ho ricevuto molte offerte, anche dalle aziende più note che potete immaginare mi hanno contattato, ma ho deciso di sfruttare la mia giovinezza per diventare cofondatore di una nuova startup; i dettagli non sono ancora pubblici, per ora lavorerò in silenzio.
Le principali direzioni per il 2025 sono da un lato l'inferenza dei large model, dall'altro l'apertura della black box dei modelli.
Dalla pubblicazione, alla fine del 2024, del nostro lavoro sull'inferenza nello spazio latente continuo (coconut, COLM’25), nel 2025 si è scatenata una vera ondata di ricerca su questo tema. Molti hanno esplorato come utilizzare questa idea nel reinforcement learning e nel pre-training, come migliorarne l'efficienza di training e calcolo, ecc.
Anche se il nostro gruppo è stato poi "arruolato" per lavorare su llama e non abbiamo potuto approfondire molto, questa tendenza mi ha dato molta soddisfazione.
Nonostante ciò, nella prima metà dell'anno abbiamo pubblicato un'analisi teorica (Reasoning by Superposition, NeurIPS‘25), mostrando in quali ambiti l'inferenza nello spazio latente continuo offre vantaggi, ottenendo una certa attenzione.
Un altro tema è come migliorare l'efficienza di inferenza dei large model. Il nostro lavoroToken Assorted (ICLR’25), prima addestra tramite VQVAE token discreti nello spazio latente, poi fonde questi token discreti con token di testo per il post-training, riducendo il costo d'inferenza e migliorando le performance.
Il nostroDeepConf valuta la fiducia di ogni token generato per decidere se interrompere anticipatamente un percorso inferenziale; così il numero di token usati nell'inferenza diminuisce notevolmente, ma nelle situazioni di majority vote le performance migliorano.
ThreadWeaver crea catene di ragionamento parallele e vi applica il post-training per accelerare l'inferenza. Inoltre, abbiamo addestrato modelli di ragionamento su dLLM tramite RL (Sandwiched Policy Gradient), così come tentativi di apprendimento del ragionamento su modelli piccoli (MobileLLM-R1).
Sul tema della spiegabilità,Grokking (illuminazione) è un ambito che seguo da circa due anni. In passato, nelle mie analisi sul representation learning, anche se potevo analizzare la dinamica dell'apprendimento e vedere le cause del collasso delle rappresentazioni, rimaneva misterioso che tipo di rappresentazioni emergessero, quale fosse la relazione con la struttura dei dati in input e quale il grado di generalizzazione. Analizzando il fenomeno di emersione della caratteristica Grokking, dalla memoria alla transizione verso la generalizzazione, si può finalmente svelare questo mistero.
All'inizio era davvero difficile e non sapevo da dove partire; nel 2024 abbiamo pubblicatoCOGS (NeurIPS‘25, vediIl ricercatore, senza curarsi del clima (X)), ma l'analisi era limitata a casi particolari, e non ne ero soddisfatto.
Dopo più di un anno di smarrimento, e molte interazioni con GPT5, il recente articoloProvable Scaling Laws rappresenta una svolta importante: riesce ad analizzare aspetti che la precedente struttura lineare (NTK) non poteva mostrare e chiarisce la dinamica di training dell'emergere delle feature. Sebbene gli esempi analizzati siano ancora particolari, almeno si è aperta una nuova finestra. Per spiegazioni dettagliate si vedaLe idee di Tian Yuandong.
L'articolo di fine annoThe path not takenmi è molto piaciuto: offre una prima risposta, a livello di pesi, sul motivo per cui i comportamenti di RL eSFT sono così diversi.
L'SFT causa overfitting ecatastrophic forgetting; la causa superficiale è che i dati di training non sono on-policy, mentre la causa profonda è che la componente principale dei pesi viene drasticamente modificata da dati esterni, rendendo "instabile la radice" e peggiorando le performance del modello.
Nel RL invece, grazie all'addestramento con dati on-policy, la componente principale dei pesi non cambia, cambiano solo le componenti secondarie, evitando così il problema del catastrophic forgetting; inoltre, la distribuzione dei pesi modificati risulta più sparsa (soprattutto nella quantizzazione bf16).
Molti pensano che la spiegabilità, o il problema del "perché l'AI funziona così bene", non sia importante, ma per me lo è moltissimo. Immaginiamo due scenari futuri:
Scenario uno: se tramite lo scaling raggiungiamo AGI o addirittura ASI, il valore del lavoro umano crolla a zero, e l'AI, come una gigantesca scatola nera, risolve tutti i problemi per noi. Come fare in modo che questa superintelligenza sia sempre benevola, non ci inganni e non faccia il male in modo nascosto, diventa la questione più urgente; per risolverla occorre la spiegabilità.
Scenario due: se la strada dello scaling fallisce, e l'umanità soccombe di fronte all'aumento esponenziale della domanda di risorse, dovremo cercare altre soluzioni: dovremo capire "perché i modelli funzionano e cosa li fa fallire". In questa catena di ragionamenti, la ricerca torna centrale e la spiegabilità è l'altra strada percorribile.
In entrambi i casi, alla fine sarà la spiegabilità a risolvere la situazione. Anche se l'AI diventasse un dio onnisciente e onnipotente, la curiosità e la natura esplorativa dell'uomo porteranno comunque a studiare il perché l'AI funzioni così bene.
Dopotutto, la "scatola nera" genera inevitabilmente una catena di sospetti. Oggi, con l'esplosione della tecnologia dei large model che raggiunge e supera la media umana, la regola della "Foresta Oscura" de "Il problema dei tre corpi" potrebbe manifestarsi in un altro modo.
Attualmente, aprire la black box di un modello già addestrato per trovare i circuiti è ancora in una fase molto preliminare.
La vera difficoltà della spiegabilità sta nell'affrontare la questione dai primi principi: dall'architettura del modello, dalla discesa del gradiente e dalla struttura intrinseca dei dati, spiegare perché il modello converga verso caratteristiche e circuiti disaccoppiati, sparsificati, a bassa rank, modulari e componibili; perché esistano molte spiegazioni diverse; come queste strutture emergenti siano correlate agli iperparametri del training e in che modo, ecc.
Quando saremo in grado di dedurre direttamente dalle equazioni della discesa del gradiente la necessità dell'emergere delle caratteristiche nei large model, la spiegabilità passerà finalmente dalla raccolta di "evidenze biologiche" alla deduzione di principi "fisici", guidando la pratica e aprendo la strada alla progettazione della prossima generazione di AI.
Rispetto alla fisica di quattrocento anni fa, oggi abbiamo molti Tycho Brahe dell'AI (che raccolgono dati), alcuni Keplero dell'AI (che formulano ipotesi), ma non ancora un Newton dell'AI (che scopre i principi).
Quando arriverà quel giorno, sono convinto che il mondo sarà rivoluzionato.
Esclusione di responsabilità: il contenuto di questo articolo riflette esclusivamente l’opinione dell’autore e non rappresenta in alcun modo la piattaforma. Questo articolo non deve essere utilizzato come riferimento per prendere decisioni di investimento.
Ti potrebbe interessare anche
Le preoccupazioni sull’AI colpiscono i titoli tecnologici, i fondi di selezione azionaria come Tiger Global e Lone Pine subiscono gravi perdite a ottobre
A causa delle preoccupazioni riguardanti le prospettive di investimento nell'IA e l'impatto delle elezioni di metà mandato negli Stati Uniti, diversi importanti hedge fund long-only hanno subito gravi perdite: Lone Pine ha perso circa il 9% e è passato in negativo per l'anno; Tiger Global è sceso dell'8,5%, azzerando i guadagni precedenti; il fondo hedge di Atreides è crollato del 16%. Coatue, in controtendenza, ha registrato un incremento dello 0,2%, distinguendosi come uno dei pochi punti positivi. I fondi multi-strategy e quantitativi hanno avuto perdite relativamente più moderate.

Oklo registra il maggior aumento da oltre un anno! Risultati del Q3 superiori alle aspettative, il primo impianto nucleare commerciale entra nella fase di costruzione della struttura principale|Resoconto finanziario
I ricavi di Oklo nel terzo trimestre hanno raggiunto 1,86 milioni di dollari, superando le aspettative; anche la perdita per azione è risultata migliore delle previsioni. La prima centrale nucleare Aurora della società ha già avviato l'installazione della struttura in acciaio principale e completato lo scavo dell'area del reattore, ottenendo inoltre l'approvazione preliminare dell'analisi di sicurezza dal Dipartimento dell'Energia degli Stati Uniti. Inoltre, venerdì Oklo ha annunciato di aver firmato un accordo con U.S. Forged Rings che garantisce la capacità produttiva per 27 moduli di reattori Aurora. Venerdì il titolo Oklo ha chiuso in rialzo del 23%.
SpaceX rimbalza di oltre il 9%, Elon Musk afferma: i ricavi del Q4 dovrebbero crescere del 70%, obiettivo 500 miliardi per l’anno prossimo
Il prezzo delle azioni di SpaceX è aumentato fino al 9,1% venerdì. Elon Musk, al Barons Investment Conference, ha previsto una crescita dei ricavi del quarto trimestre del 70% su base trimestrale e ha ribadito l'obiettivo di raggiungere un fatturato annualizzato di 100 miliardi di dollari entro quest'anno; entro la fine del 2027, questo numero supererà i 500 miliardi di dollari. Inoltre, la quota dei contratti governativi scenderà dal 16,6% a meno del 10%. Tuttavia, nonostante il recupero a breve termine, le azioni sono comunque diminuite di oltre il 28% negli ultimi mesi.
Il rapido raffreddamento del rimbalzo eccessivo dei “nuovi cloud” AI! CoreWeave è passato improvvisamente da un aumento a una diminuzione, il rialzo di IREN si è dimezzato
Giovedì le azioni AI statunitensi sono state oggetto di forti vendite: CoreWeave, Nebius e IREN sono scese rispettivamente di circa il 10%, 15% e 17%. Dopo la chiusura di giovedì, la trimestrale di IREN ha superato le aspettative, con una significativa crescita dei ricavi dal segmento AI Cloud. In combinazione con un forte rimbalzo delle azioni tecnologiche venerdì mattina, nel pre-market statunitense CoreWeave è salita del 9,3%, IREN del 24,6% e Nebius del 13,7%. Successivamente, a metà seduta, i media americani hanno riportato che Microsoft non rinnoverà parte della sua locazione di capacità di calcolo con Oracle, colpendo nuovamente il sentiment di mercato che aveva mostrato segni di miglioramento, e il settore Neocloud ha visto ridursi i rialzi.

Prezzi delle criptovalute
Altro


